本文主要讨论 KVCache 在 Agent Harness 设计上如何做到更好的利用,在保证正确率的情况下,尽可能减少 Agent 使用开销。
所有实验基于我的开源项目 WhalePod,项目中也包含了 benchmark 代码和本文中的结果。
注意 - WhalePod 的上下文管理实验复现有一条隐形要求:确保你的模型(DeepSeek-V4 比如)的自动前缀缓存能在长对话中持续生效(因为梁圣的 KVCache 保存时间目前是最久的,似乎长达 2h),在此基础上让请求的字节前缀保持稳定。
本文的设计则是在应用层,在其他层间各种设计的基础上,如何真正在使用 Agent 的过程中利用好 KVCache 带来的增益。
接下来我们从架构原理、评测系统设计和完整实验数据三个层面,系统性地验证让前缀字节流稳定产生的增益。
涵盖两条互补轨道的完整流程:离线预测(零网络/API key 得到的理论结果)和在线实测(请求 DeepSeek 看看花了多少钱),以及两个维度的评价指标——可复用前缀份额(reusable prefix ratio)和命中率(cache hit rate)。
全文用 60 个独立 session、三种对话长度(6/12/18 轮)和三种推理回放策略(never/tool/always)的数据来论证设计的稳健性。在bench目录可以找到素有实验的复现入口。
如果你很急,也可以直接看 评测目标、我们的Agent 架构设计:为何前缀缓存能命中、实验结果,或者和市面主流 Agent 的对比。
0. 稍等,我刚来,你们在聊的 KVCache 是什么?
0.1 理论
KV Cache 是基于 Transformer 架构的自回归 LLM 在推理解码(Decode)阶段使用的一种以空间换时间的显存优化机制。
首先我们知道,标准的多头自注意力机制(Self-Attention)是: \(\text{Attention}(Q, K, V) = \text{softmax}\left(\frac{Q K^T}{\sqrt{d_k}}\right) V\)
在自回归文本生成过程中,模型按是按步(时间) $t$ 逐个生成 Token 的:
- Prefill 阶段:模型对输入的 长度为 $N$ Prompt 序列并行计算所有 Token 的投影矩阵,得到 $Q_{1:N}, K_{1:N}, V_{1:N}$,完成第一次注意力计算,并将生成的 $K_{1:N}$ 和 $V_{1:N}$ 暂存在显存中。
- Decode 阶段:当生成第 $t+1$ 个 Token 时,KVCache 的设计使模型只需针对新 Token 生成单行查询向量 $q_{t+1}$ 以及对应的 $k_{t+1}, v_{t+1}$。接下来将新计算的键值向量追加至缓存中: \(K_{1:t+1} = [K_{1:t} \,;\, k_{t+1}], \quad V_{1:t+1} = [V_{1:t} \,;\, v_{t+1}]\) 然后仅通过 $q_{t+1}$ 与完整的 $K_{1:t+1}, V_{1:t+1}$ 计算单向量对矩阵的注意力: \(\text{Attention}(q_{t+1}, K_{1:t+1}, V_{1:t+1}) = \text{softmax}\left(\frac{q_{t+1} K_{1:t+1}^T}{\sqrt{d_k}}\right) V_{1:t+1}\)
本质上,KVCache 做的事情是一个 消除冗余计算 的任务。也就是避免了每生成一个新 Token 都对历史所有 Token 重新算 $K$ 和 $V$ 向量(重新执行投影线性变换,Linear Projections),使每一步的计算复杂度由全局重算的 $O(t^2 \cdot d)$ 降低为增量计算的 $O(t \cdot d)$。
这里的 $d$ 指 hidden layers 的总维度,因为每生成一个 Token,需要与历史 $t$ 个 Token 的向量分别做内积计算,每个向量的长度是 $d$。
由于这个空间换时间的做法,KV Cache 让解码阶段系统吞吐瓶颈从算力变成了 GPU 显存容量与 HBM 读写带宽。
0.2 在我们动手之前,还发生了什么
由于长上下文与并发请求会导致 KV Cache 显存爆炸:
$O(\text{Batch} \times \text{Length} \times \text{Layers} \times \text{Heads} \times d)$
工业界和学术界围绕 KV Cache 衍生出了一系列关键技术。其中与提高缓存命中率相关的:
1. 模型架构级优化
主要在减少 KV Head 数量与维度上。
- MQA (Multi-Query Attention):所有 Query Head 共享单一组 Key/Value Head,KV Cache 显存占用直接降低到原本的 $1/H$($H$ 为注意力头数)。
- GQA (Grouped-Query Attention):折中方案(如 Llama 2/3、Mistral),将 Query Head 分组,每组共享一对 Key/Value Head,在保持模型精度的同时大幅削减 KV 显存。
- MLA (Multi-Head Latent Attention):DeepSeek-V2/V3 提出的创新架构。将 Key 和 Value 联合投影压缩为一个低维的隐向量(Latent Vector),仅缓存该隐向量,在推理时通过矩阵吸收(Matrix Absorption)还原计算,将 KV 显存开销降低至原本的 10%~20% 左右。
2. 显存管理与系统级优化
- PagedAttention (vLLM):借鉴操作系统虚拟内存分页的思想,将连续的 KV Cache 离散存储在固定大小的物理显存块(Block)中,彻底解决了显存内外部碎片问题,将显存浪费率从 >60% 降至 <4%。 分页机制消除了内部与外部显存碎片,相当于释放出来的有效显存可以容纳更多并发与前缀块,其实是间接提升了命中率的上限。
- RadixAttention / 前缀树缓存 (SGLang 等):采用基数树(Radix Tree)管理 KV Cache,实现跨请求、跨轮次、树形搜索(Tree-of-Thought)分支场景下的前缀精确复用与自适应 LRU 淘汰。 主要是因为 Radix Tree 在内存中维护所有历史请求的 KV Cache,这样对多轮对话(显然)直接把上轮的上下文全复用了;同一 Prompt 分叉生成多个候选回答时,分叉前的公共前缀只需计算一次;对不同用户的不同请求只要开头一致,树结构也可以精确匹配并直接命中前缀。
3. 缓存压缩与稀疏化 / Compression & Eviction
- KV 极低比特量化:
- 将 KV Cache 从 FP16/BF16 量化为 FP8、INT8 或 INT4(如 KIVI、Q-Serve),直接让显存占用减半甚至降低至 $1/4$,成倍扩大并发容量。 比如将每个 KV 浮点数从 16 位压缩到 8 位甚至 4 位, Token 的显存占用变小了,内存中缓存的条目就翻倍了。
- Token 动态淘汰与稀疏注意力:
- StreamingLLM:保留最开头的几个“注意力汇聚点(Attention Sinks)”和最新的局部滑动窗口 Token,丢弃中间大部分 KV Cache,以固定显存支持无限长上下文流式输出。
- H2O (Heavy Hitter Oracle) / Scissorhands:基于历史注意力权重,动态识别并保留贡献最大的“Heavy Hitter Token”,丢弃不重要的 Token 缓存。
4. 分布式与分层存储 / Disaggregated & Tiered Caching
- 分层缓存卸载(Hierarchical KV Caching,如 Mooncake):构建
GPU HBM -> Host DRAM -> 本地 NVMe SSD -> 分布式存储的多级缓存系统,在超长文本及海量 Prompt 共享场景下,把不活跃的 KVCache 换到成本低容量大的地方存。 即使很久没被调用,也能在 CPU 内存中命中并快速拉回 GPU,避免冷启动重新计算。
背景到这里结束。站在其他设计的肩膀上,我们来看看 Agent 本身是否存在设计范式来提升 KVCache 利用率。
1. 评测目标
KV cache 的命中率是一个成本指标,不是一个正确性指标。我们追求的不是”命中率高”,而是”在保证功能完整的前提下命中率高的同时 prompt token 总量低“——命中率一样但灌入了过多 token 的设计同样不省钱。
两条轨道:
| 轨道 | 环境 | 测量对象 | 输出 |
|---|---|---|---|
离线validate.py |
零网络、零 API key | 请求之间的字节前缀可复用比(理论上限) | 四种上下文设计的对比 |
在线live_acceptance.py |
真实服务器 | 服务器报告的 prompt_cache_hit_tokens(实际命中) |
命中率验证 + 预测一致性 |
离线说实验的意义在于说明理论上最多应该有多少token复用;在线实验则实际查看服务器确实有多少复用。 两者之间的差距(MAE)衡量我们的理解与服务器行为的一致程度。
2. 代码文件
评测系统全部放在 bench/ 目录下,外加 whalepod/core/tokenizer.py 和 tests/test_bench_encoding.py 两个支撑文件。每个文件职责如下:
离线验证引擎
bench/validate.py 完全不依赖网络。其工作机制:
ScriptedEndpoint(继承VLLMEndpoint):替代真实 HTTP 连接,在内存中按预设脚本复读应答。因为走的是真实的_payload()构建消息、真实的 Agent 循环,所以测量的是生产代码路径,不是手工模拟。wire_text(payload):将发出的 OpenAI 格式 JSON 转为模型真正接收的输入字符串。调用的是bench/dsv4_encoding.py里的encode_messages(),该函数来自 DeepSeek V4-Flash-0731 的官方仓库,处理 BOS、角色分隔符(<|User|>/<|Assistant|>)、tool schema 挂载到 system message、tool result 合并到 user message 等所有细节。common_prefix_len(a, b):对两个连续请求的输入字符串做二分查找,找最长公共前缀(字节级)。estimate_tokens(shared_prefix):用 (DeepSeek V4 的)官方 BPE tokenizer 计算数 token,然后按 64-token 块边界截断。measure(payloads):对全部请求对执行wire_text → common_prefix_len → estimate_tokens → blocks,输出每个请求的RequestMetrics。
五个独立实验:
| 实验 | CLI | 测量什么 |
|---|---|---|
variants |
默认 | as-built / no-ledger / rolling-summary / three-zone 四种设计跑同一个 session |
variants-small |
自动触发 | 同上,但窗口缩小到 ~45k,迫使所有设计都 prune |
prune |
默认 | as-built 在 45k 窗口下观察 prune 后前缀恢复曲线 |
repomap |
默认 | repo map 在不同 token budget 下的实际渲染 token 数 |
deny |
默认 | sandbox=--yes 模式下危险命令的拒绝链 |
三个子实验:
| 选项 | 测量什么 |
|---|---|
--only main |
12 轮 session,--repeat N 跑 N 次取分布 |
--only prune |
同上,但窗口缩小到 ~45k(强制 prune) |
--only pin-check |
Provider affinity A/B:同一 prefix,pin 到 provider vs 自由路由 |
DeepSeek V4 官方消息编码器
bench/dsv4_encoding.py,从 HuggingFace deepseek-ai/DeepSeek-V4-Flash-0731 vendor 来的,MIT 许可。
wire_text 调用 encode_messages 把 OpenAI 格式的消息列表转为模型需要的输入字符串(BOS + 角色分隔符 + tool schema 渲染 + tool-result 合并)。
而非自造的 JSON dump,使得离线测量的字节流和服务器实际 tokenize 的完全一致。
回归测试
tests/test_bench_encoding.py 八个测试用例覆盖:
- tokenizer 优先级:无 dsv4 tokenizer 时回退到 tiktoken/heuristic
wire_text确定性:相同 payload 产生相同字节wire_textencoder 验证:输出包含 BOS、<|User|>、<|Assistant|>,不包含"role":"system"- tool result 被合并进 user message(V4 无独立 tool 角色)
- 不同首消息打破前缀
3. Agent 架构设计:为何前缀缓存能命中
KV cache 的命中率不取决于任何模型调参,取决于代码结构。以下七个设计决策是 95% 命中率的基石。
3.1 两区消息存储:不可变前缀 + 只追加历史
WhalePod 的消息管理器(whalepod/core/messages.py)把消息分成两个区:
Zone 1 — 稳定前缀(不可变)
├── tool definitions     ← 本轮启用的工具,session 开始时确定,全 session 不变
├── system prompt        ← 静态系统提示词(`whalepod/core/prompt.py`),无 cwd/时间/模式
└── repo-map summary     ← 仓库符号表(`whalepod/context/repo_map.py`),token-budget 约束

Zone 2 — append-only 历史                          ⟵ 从未被就地改写,只在末尾追加
├── turn 1: user → assistant → tool results
├── turn 2: user → assistant → tool results
└── ...
分区原则: Zone 1 完全不变、Zone 2 只新增不修改。在此基础上越容易改变的的内容放在越后面。
为什么重要: KV cache 以最长公共前缀为 key。根据我们的设计原则所以每个新请求的前缀都等于”Zone 1 + Zone 2 的已发送部分”,和上一个请求的前缀完全重叠。
prompt 放在 repo-map 前面不是偶然。prompt 是 session 直不变的,repo-map 在 /refresh 后可能更新。
如果 prompt 在 repo-map 之后,一次 /refresh 会破坏整个系统提示词的缓存,剩下的 byte 全部被重新计费。
prompt 在前意味着 /refresh 只破坏 map 的那一小段尾缀。
3.2 Context Ledger: 拦截重复读
whalepod/core/ledger.py 记录了每个已送入上下文的文件范围(path + start + end)+ 文件身份(mtime_ns + size)。
当模型请求某个文件时,Agent 走两条路径(whalepod/core/agent.py:_run_read):
模型请求 read_file("messages.py", start=1, end=50)
  ↓
ledger.hit(path="messages.py", start=1, end=50)?
  ├─ YES → 返回指针,不发送文件:
  │         "[ledger] messages.py:1-50 is already in the window (from turn 1)"
  │         零额外 token
  └─ NO  → 发送完整文件内容
             记录 entry: (path, start, end, mtime_ns, size, turn)
文件被编辑后(WhalePod 自己的 edit 或者外部修改),invalidate() 删掉对应的 ledger 条目,让后续请求重新读到真实内容。
为什么重要: 在 turn 4、7、9、11 中,模型重复请求了已经读完的文件。没有 ledger,每次重复读都会往上千 token。12 轮 session 中,ledger 省下了 ~17k token(离线测量)。在更长 session 中效果更大。
3.3 Provider Affinity:前缀缓存始终单机
这个设置只对 OpenRouter 等会路由到不同推理服务提供商的接口才有意义。
whalepod/core/base.py:extra_body 在 OpenRouter 上把请求 pin 到一个 provider: {order: ["DeepInfra"], allow_fallbacks: false}。前缀缓存在某一台服务器的 KV cache 中,聚合器的正常行为是把每个请求路由到不同 provider,每个请求都是冷 miss。
实测数据:同一 11.2k 前缀,不 pin 0.4% 命中率,pin 到指定 provider 98.4%。
直连 DeepSeek 官方 API 时不需要额外配置(本身就是单 endpoint),这个设计主要面向 OpenRouter。
3.4 Reasoning 按需回传
DeepSeek 明确要求没有工具调用时中介 assistant 的 reasoning_content 无需回传,传了也会被忽略; 而发生了工具调用时,它必须参与上下文凭借并在后续所有请求中原样回传,否则 DeepSeek 的 API 会返回 400(官方文档说的,但实际目前并不会)
因此 chain-of-thought 不能无条件回放到后续请求中。我准备了几种设计:
- never:一律不写入 payload,只保留在本地 UI 中显示;
- tool(默认):仅当该 assistant 回合调用了工具(
m.tool_calls)时回传思考,纯回答回合照旧剥离; - always:每个回合都回传,适用于 Kimi K3 等模型。
为什么重要: 一次思考动辄几百上千 token。如果不加约束地回放,每个 assistant 回复都带着一大段思考回到前缀里——第一第二次能缓存,但几个 turn 之后整个区域都是几十 K 的推理文本,prompt 总量被成倍放大。 默认策略只在”必须解释工具决策”的回合保留思考,其余剥离。§6.4 用三种策略各 10 次 session 量化了这个旋钮的成本与收益。
同时,我注意到一个上古时期 Agent 和推理框架可能存在的问题。就是如果不通过 reasoning_content,wire-level 的 CoT 带上 <think> 等 special token 时,
服务端对新请求做 tokenize 会把这些文本按普通 BPE token 重新切分,导致服务端生成的控制 token 与客户端回发时切好的普通文本 token 在 BPE 结果上不一致。
这是一种现代推理服务 tokenize 之前的安全机制,不然人人都可以随意注入 special token 了。
3.5 扩充工具描述,但只放可用工具
Zone 1 里除了 system prompt 还包含 tool definitions。
WhalePod 把工具的使用指南(guidelines)和工具的 JSON schema 写进同一个定义位置(whalepod/tools/registry.py:_schema)。
注意 guidelines 是自留的备注字段,不属于 wire schema。
_schema("edit_file",
        "Replace an exact substring in a file...",   # ← wire schema 的 description
        {...},
        guidelines=[                                  # ← prompt 行,不进 wire schema
            "`edit_file` needs an `old` string that occurs exactly once, "
            "copied verbatim from the file including indentation...",
            ...
        ])
session 启动时,一次性过滤出启用的工具集,之后整个 session 不再变化。
用户只选择模式(默认 confirm、--no-tools 强制 readonly、--yes 自动批准),
工具集是模式的确定性推导,在实验(和目前的项目功能中)不手动选择。 e.g. readonly 沙盒直接剔除所有写工具。
两个字段在一个地方定义后分别送往:
一个工具的定义(schema + 使用指南)
        │
        ├─ schema 部分 ──→ 走 API 的 tools 参数
        │     schemas() 返回同一批缓存对象,并剥掉 guidelines 键。
        │     API 只认标准格式字段(name/description/parameters),
        │     多塞一个私有字段,严格的服务商会拒收整个请求(400)
        │
        └─ 指南部分 ────→ 走 system prompt 文本
              guidelines() 只收集已启用工具的指南,
              按字符串精确匹配去重、按工具顺序排列,
              交给 build_system_prompt 拼出 "Using the tools" 段落,
              以普通文字的形式让模型读到
prompt 的组装发生在 session 起点,之后字节级别冻结,运行期间整个前缀全部缓存收。
为什么重要:
- 不可用工具的 token 根本不进前缀。 比如 readonly 会话(
--no-tools),写工具的所有内容都不出现在 Zone 1。工具规则与工具列表在启动时一次组装,开始运行后就冻结了。 - 工具描述事实来源防工具理解漂移。 指南和 schema 物理上写在同一个
_schema()调用里,二者只能成对变更、成对出现。这看起来并没有直接省 token,但能防止 Agent 对工具的理解过时而犯更大错误。 - 与每请求动态组装的设计划清界限。 有些 harness 每轮重建系统提示词(注入 cwd、时间、会话模式),等于每轮主动制造一次全前缀失效。WhalePod 把变化的自由度收敛到 session 起点做一次性解析,换来整个 session 的字节稳定。
一个推论: 能力变更应该发生在 session 边界。重启严格便宜于中途改变 Agent 能力,也在安全性上(防止读脏工具等)更好。
3.6 Compaction 取代粗暴 Prune
whalepod/compaction.py:prune 在窗口超限时删除旧 turn 并留一个 marker。但 prune 掉的东西往往是 session 开头用户说的目标——永久丢失,浪费前缀也是重新计算的。
Compaction 用同一切线和同样的前缀失效成本,只是用一个小模型调用把要删除的 turn 总结成一份包含文件清单和行号范围的摘要。Compaction 失败会回退到 prune,所以用户的 turn 永远不会失败。 这里的设计其实各大产品都使用类似的黑盒压缩,Whalepod也实现了类似 pi 的消息树状的消息管理,不过这里的 compaction 无论如何都会丢失缓存,所以它的要点就变成了: 如何更好、更全面保存关键信息。树状消息缓存指针可以是解决方案之一。
为什么重要: 窗口超限时一次压缩所有前缀失效,不管是 prune 还是 compaction 都一样。Compaction 和消息指针尽可能保留了丢失的信息,让前缀在恢复后依然可以工作。
3.7 行结束符归一化:保证 BPE 稳定
whalepod/tools/textfile.py — 读取时文件内容归一化为 LF,写入时恢复为文件的原始行结束符。
没有这个处理,在 CRLF checkout 上做编辑,old 文本不匹配实际文件,编辑失败;重新读取也没用,因为 read_file 的输出也是 LF。
这是因为在 Windows 上,磁盘文件换行符通常为 \r\n。
当 LLM 尝试使用 edit_file(old="line1\nline2", new=...) 进行替换时,底层执行 disk_text.count(old) 会匹配失败 -
因为原文的 \n 匹配不上 \r\n。LLM 感到很疑惑,觉得写的就是对的,再请求,依然会报错。
因为对无论是 Python 默认的文本读取(开启了 universal newline 处理),还是工具把行拼成字符串返回,输出给 LLM 看到的文本换行符都是 \n(LF)。
这样模型只会无力地浪费 token (除非它马上猜对)。
还有很多坑点场合,比如:
- 首行包含 UTF-8 BOM(Byte Order Mark)的文件
部分 Windows 工具(如老版本 Visual Studio、记事本)保存的 UTF-8 文件会带有 \ufeff 字节。 BOM 字符在终端或 LLM 提示词中是不可见的,LLM 绝不会在 old_str 的开头带上 \ufeff。如果不剥离 BOM,针对文件第一行的所有编辑都会因为前缀不匹配而失败。
- 避免 Git Diff 污染
如果 Agent 读取了 CRLF 文件,并在修改 1 行后直接以 LF 格式写回磁盘。 用户在 git diff 中会看到整份文件的每一行都被修改了(行尾全变了,即所谓全重写现象)。restore() 方法能够保留原始的 CRLF,保证只有真正修改的那 1 行出现在 diff 中。
- 混合换行符文件的平滑修复
由于多人协作或跨平台合并,某些文件内部同时存在 \r\n 和 \n 的情况也能处理。
为什么重要: BPE tokenizer 对 \r\n vs \n 产生不同的 token 序列。如果行结束符在编辑过程中改变,文件内容的编码就变了——对于包含该文件的请求,前缀中的对应部分不再复用。
4. 评测架构
共享的 Session 脚本
离线四个变体和在线实测共用同一组 12 轮对话(定义在 bench/validate.py:SESSION):
turn  1: "Where is prefix caching handled?" → grep + read_file messages.py
turn  2: "How does the ledger stop duplicates?" → read_file ledger.py
turn  3: "Walk me through the agent loop." → read_file agent.py
turn  4: "Remind me the prune thresholds." → read_file messages.py (re-read!)
turn  5: "What tools does the registry expose?" → read_file registry.py
turn  6: "Show me the endpoint abstraction." → read_file endpoints/base.py
turn  7: "In agent.py, where is the ledger consulted?" → read_file agent.py (re-read!)
turn  8: "Compare the two provider implementations." → read_file vllm.py + anthropic.py
turn  9: "Does the ledger handle file edits?" → read_file ledger.py (re-read!)
turn 10: "How is the repo map budgeted?" → read_file repo_map.py
turn 11: "Which registry function plans a write?" → read_file registry.py (re-read!)
turn 12: "How is config resolved?" → read_file config.py + tree_view whalepod/
Turn 4, 7, 9, 11 是重复读(same file 已经在前面的 turn 中读过),ContextLedger 应该拦截这些请求,用指针替代文件内容。
双重验证流程
                     SESSION (12 turns)
                    /                \
       Offline (validate.py)     Live (live_acceptance.py)
       ScriptedEndpoint           RecordingEndpoint
              |                   DeepSeek API
         4 variants            5 repetitions
              |                       |
  reusable prefix per request    cached tokens per request
  (byte-level prediction)       (server measurement)
              |                       |
              +---------- MAE ---------+
                    agreement check
离线提供上限(字节层面能复用多少),在线提供实测(服务器实际给了多少缓存),两者的 MAE 衡量预测精度。MAE 小(<3 点)说明离线模型贴切;MAE 大(>10 点)说明要么 tokenizer 不对,要么字符编码模型和服务器不一致,要么 provider 端的 KV cache 被驱逐。
离线计算链路
以 as-built 变体第 2 个请求为例:
VLLMEndpoint._payload()
  → OpenAI 格式 JSON:
    {model: ..., messages: [{role:"system", content:"..."}, {role:"user", content:"..."}], tools: [...]}
  ↓ wire_text()
dsv4_encoding.encode_messages()
  → 模型输入字符串:
    <|begin▁of▁sentence|>Reasoning Effort:...<|User|>where is prefix caching...<|Assistant|><think>
  ↓ common_prefix_len()
  和上一个请求的字符串比: 15,232 bytes 共享
  ↓ estimate_tokens(prefix)
  V4 BPE → 238 tokens
  ↓ blocks()
  64-token 对齐 → 192 reusable tokens (floor to block boundary)
  ↓ RequestMetrics
  reusable_frac = 192 / total_prompt_tokens
在线则是官方服务接口直接返回 prompt_cache_hit_tokens(也就是它内部分配 KV cache 块时命中的 token 数)。
5. 实验流程
5.1 不同轮数对比实验
验证缓存在不同对话长度下的表现:
# 短对话 (6 turns)
python bench/live_acceptance.py --only main --repeat 5 --turns 6 --no-pin `
    --base-url "https://api.deepseek.com" --model "deepseek-chat"

# 标准长度 (12 turns) — 推荐 20+ repetitions
python bench/live_acceptance.py --only main --repeat 20 --turns 12 --no-pin `
    --base-url "https://api.deepseek.com" --model "deepseek-chat"

# 长对话 (18 turns)
python bench/live_acceptance.py --only main --repeat 3 --turns 18 --no-pin `
    --base-url "https://api.deepseek.com" --model "deepseek-chat"
三种长度的结果在 §6.3 中汇总比较。
推理回放策略对比(--reasoning-strip)复用同一套 12 轮 session,只切换”模型思考是否回放到下一条请求”的策略:
python bench/live_acceptance.py --repeat 10 --reasoning-strip never   # live_acceptance.json
python bench/live_acceptance.py --repeat 10 --reasoning-strip tool    # live_acceptance_rs_tool.json
python bench/live_acceptance.py --repeat 10 --reasoning-strip always  # live_acceptance_rs_always.json
python bench/reasoning_compare.py   # 生成三种策略的对比图
python bench/article_charts.py      # 生成跨 run 的全部比较图(含本表)
结果在 §6.4 汇总。
5.2 规模
| 场景 | 推荐 N | 时间 | 预算 |
|---|---|---|---|
| CI 冒烟测试 | 1 | ~3 min | ~$0.02 |
| 内部验证 | 5 | ~15 min | ~$0.10 |
| 统计显著性 | 20+ | ~70 min | ~$0.40 |
P10–P90 跨度小于 3 点说明 provider 稳定、结果可信;跨度 >10 点说明 KV cache 不稳定,换 endpoint 或缩小上下文。
6. 实验结果
6.1 离线验证(2026-08-05,V4 BPE tokenizer)
| Variant | Prompt tokens | Reusable | Reuse % | Prompt cost |
|---|---|---|---|---|
| as-built | 911,083 | 858,240 | 94.2% | $0.020 |
| no-ledger | 1,099,805 | 1,030,528 | 93.7% | $0.025 |
| rolling-summary | 518,504 | 465,216 | 89.7% | $0.013 |
| three-zone | 913,223 | 405,312 | 44.4% | $0.053 |
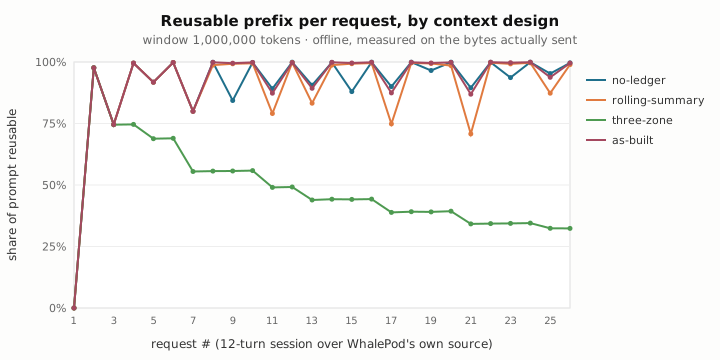
- as-built 在每个 turn 之间保持 99.6% 的可复用前缀,只有新文件内容进入时才跌到 76–89%。
- no-ledger 的可复用前缀率和 as-built 差不多(93.7% vs 94.2%),但灌入了 20% 更多的 token(~1.1M vs ~911k)。前缀可复用只是一个比率,token 总量少才是省钱的根本。
- rolling-summary 每次总结时丢掉一大段历史,前缀无可复用基础,只能靠压缩后体积小来减成本——但在实践中,每次总结会产生一个全新的 prompt(没有前缀复用),而 as-built 靠缓存大量 token 以 5x 折扣价(缓存 token 的 20% 计费)。
- three-zone 把”当前文件内容”放在历史后面,每个请求都有尾缀变动,前缀复用持续下降到 44.4%——这个设计在看过图表后就没写出来。
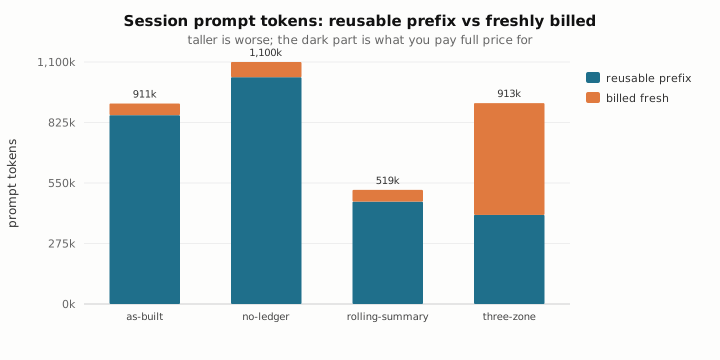
堆叠图清晰地看到:as-built 的柱子最矮(总 token 最少),且绿色(可复用)比例最高。no-ledger 柱子更高(更贵),three-zone 灰色(新鲜)部分最多(最贵)。
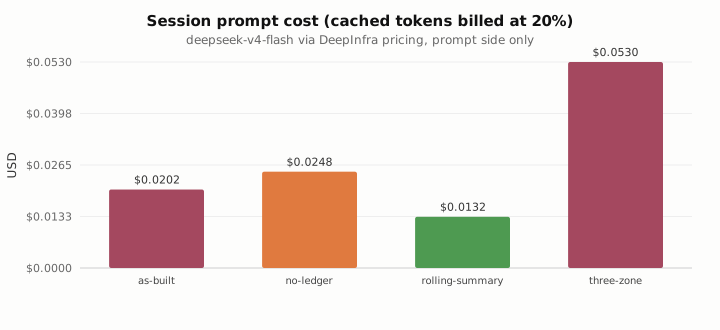
成本对比:as-built $0.020,no-ledger $0.025(+23%),three-zone $0.053(+162%)。rolling-summary 的柱子矮是因为它压缩了上下文所以 token 总量少,但这是以牺牲信息为代价换来的。
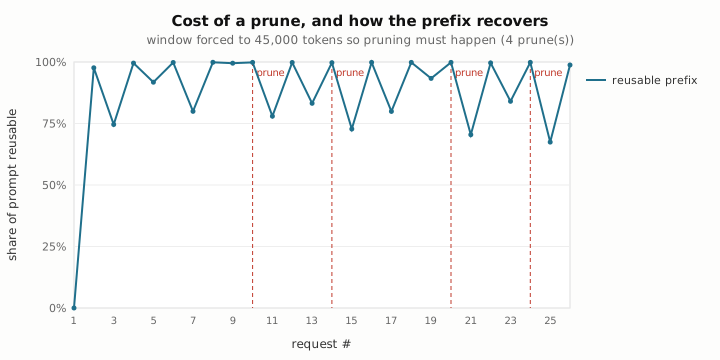
在小窗口下,prune 后的前缀恢复是瞬时的:一次 prune 掉到 ~0%(红色虚线标出),下一个请求立即恢复到 ~90%,session 整体仍保持 88.8% 的可复用比。这就是 prune 的全部代价。
6.2 在线实测 — 12 轮对话(2026-08-06,DeepSeek 官方 API)
配置:https://api.deepseek.com,deepseek-chat(V4-Flash),22 次重复,12 turns。
| Metric | Result |
|---|---|
| Sessions | 22 × 12 turns |
| Requests per session | 37(max observed) |
| Session 命中率 | median 94.7% (P10=93.7%, P90=95.3%) |
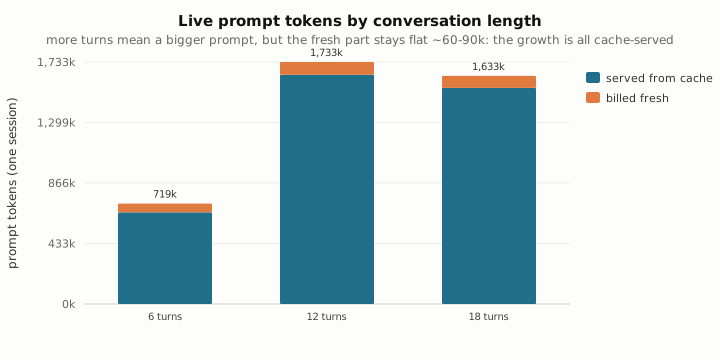
| Session prompt tokens | 1,732,599(1,640,960 cached, 91,639 fresh) |
| 预热曲线 | 前 3 请求综合平均 87.1% → 后 3 请求综合平均 98.2% |
| 离线 vs 实测 MAE | 5.5 点(改前 7.0) |
| ledger 省量 | 2,015 tokens(1 次去重) |
22 次独立 session,命中率中位数 94.7%。P10=93.7%,P90=95.3%,跨度仅 1.6 点——评测结果具有统计学意义上的一致性。预热曲线显示:前 3 个请求平均 87.1%(第一次请求在 22 次重复中的命中率中位数即达 99.8%,因为服务端 KV cache 已被前面的 session 预热),随后进入稳态;22 次重复中 32/37 个请求达到 89% 以上。离线预测 MAE 为 5.5 点(+tokenizer/encoder 改进前为 7.0)。
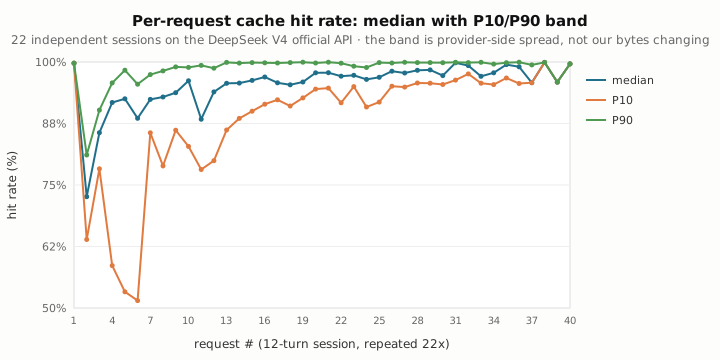
上图把 22 次 session 的 per-request 命中率归并成一条 median 线并带上 P10/P90 带宽:第 1–4 个请求(冷启动)median 从 73% 快速爬升;请求 13 之后 median 稳定在 95–100%,带宽收窄到 14 点以内,到请求 21 之后进一步收窄到 8 点以内。前 12 个请求带宽较宽(最高 45 点)不是 provider 抖动——那是 22 次重复里”轮到新 turn 读入新文件”的请求在相同索引上错位对齐造成的字节前缀变化,正是离线模型能预测、设计应负责的部分。这张图是 §6.3 里”12 turns”那条的细粒度版本。
6.3 不同对话长度的对比
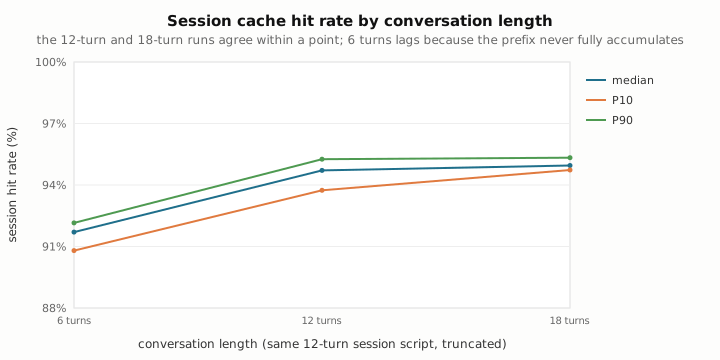
为了验证前缀缓存在不同长度对话中的表现,用同一套 session 脚本分别跑 6、12、18 轮,每个长度重复多次。
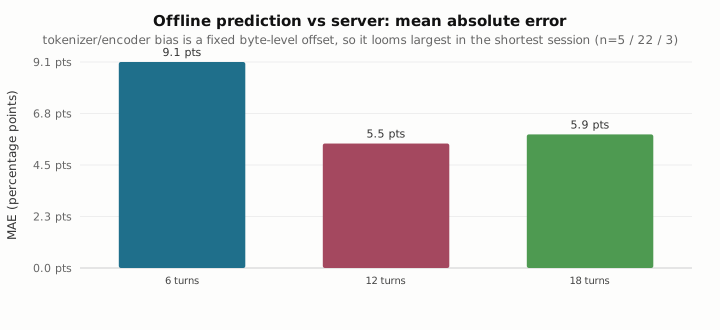
| 对话长度 | 重复次数 | 请求数/次 | 命中率中位数 | P10 | P90 | MAE |
|---|---|---|---|---|---|---|
| 6 turns | 5 | 20 | 91.7% | 90.8% | 92.2% | 9.1 |
| 12 turns | 22 | 37 | 94.7% | 93.7% | 95.3% | 5.5 |
| 18 turns | 3 | 33 | 95.0% | 94.7% | 95.3% | 5.9 |
趋势分析:
- 短对话(6 turns)命中率最低(91.7%):前缀积累不足。每个新 turn 的文件内容占前缀总体的比例更大,所以冷内容频率更高。MAE 也最高(9.1),因为 tokenizer 偏差越大在短上下文里越明显。
- 12 turns 到 18 turns 命中率增长趋缓:+0.3 个百分点——前缀缓存效果在 12 轮时已经接近最大值,再拉长对话对缓存的帮助不大。这正是设计预期的结果。
- P10–P90 跨度始终很窄(<3 点):不管是短对话还是长对话,分布在 2 个点以内,说明是设计本身的可持续行为,不是偶然运气的单点估计。
- 新鲜计费 token 几乎不随长度增长:三种长度下每 session 的 billed-fresh 都只有 ~60–90k,prompt 总量的增长全部来自缓存命中的部分——对话越长,缓存分摊得越多,边际成本趋近于零。
结论:12 turns 是实验甜点。足够长,让缓存充分生效;足够短,能在小时内跑 22 次取分布。
6.4 推理回放策略 A/B(2026-08-11,DeepInfra pin)
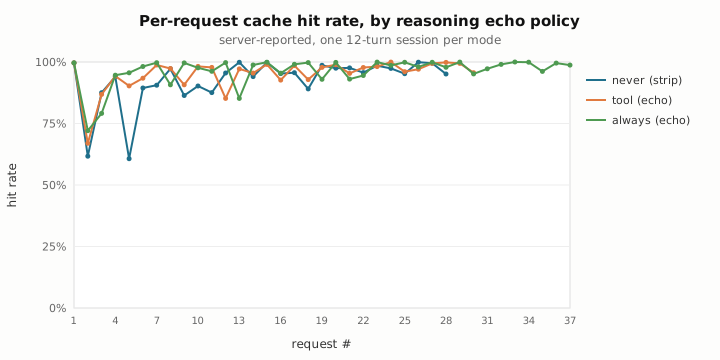
§3.4 把 reasoning 回放定性为”命中率 vs 总字节”的旋钮。为了量化”回放”到底会付出多少、换回多少,我们对 --reasoning-strip 的三种策略各跑 10 次 12 轮 session(同一套脚本、同一 provider):
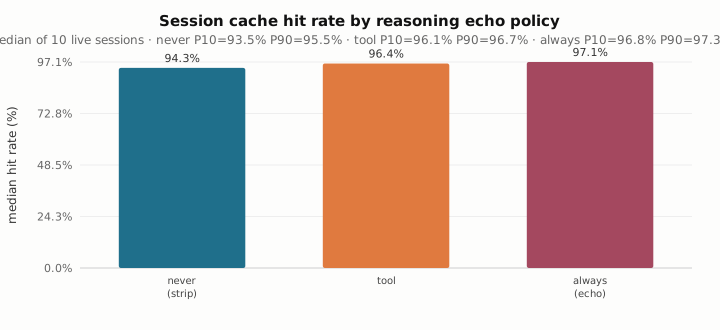
| 策略 | Sessions | 命中率中位数 | P10 | P90 | MAE | Reasoning tokens | Prompt tokens | Fresh |
|---|---|---|---|---|---|---|---|---|
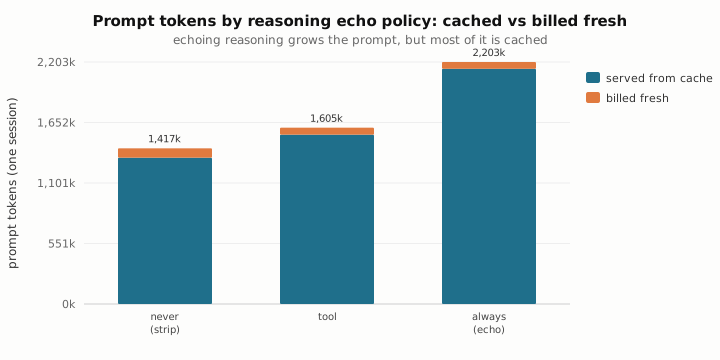
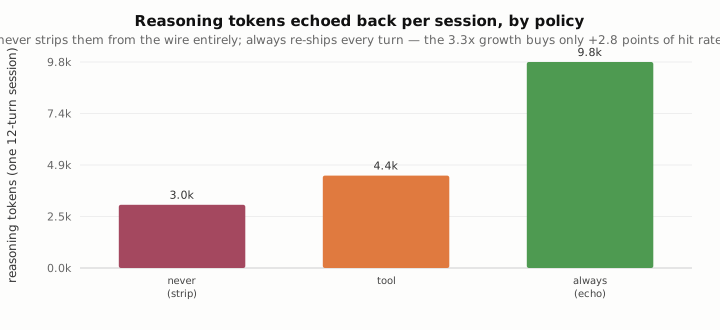
| never(一律剥离) | 10 | 94.3% | 93.5% | 95.5% | 6.4 | 3,018 | 1,416,947 | 85,363 |
| tool(生产默认,仅工具轮回放) | 10 | 96.4% | 96.1% | 96.7% | 3.7 | 4,408 | 1,604,825 | 63,577 |
| always(每轮回放) | 10 | 97.1% | 96.8% | 97.3% | 3.7 | 9,830 | 2,202,948 | 61,764 |
读图结论:
- 回放确实提高命中率:always 把 median 从 94.3% 抬到 97.1%(+2.8 点),P10/P90 跨度反而收窄到 0.5 点。reasoning 进入前缀后,前缀更大、更连续,每个请求的可复用部分更多。
- 但代价是 prompt 体积暴涨:always 的 prompt 总量是 never 的 1.55 倍(2.2M vs 1.4M),reasoning token 从 3,018 涨到 9,830(3.3 倍)。这些 token 虽然大部分能缓存(缓存价 ~20%),但首次进入和每次新回合的思考都会造成一次冷写入,且缓存写入本身按 miss 计费。
- fresh 反而下降(85k → 62k):reasoning 占满了本该”浪费”的冷区间,把缓存未命中填满了——这是命中率数字上升的直接原因,但它买的是”把更多的字节变成缓存”,不是”省钱”。
- tool 策略是生产默认,也是折中:命中率 +2.1 点、reasoning 只多 +46%,prompt 只 +13%,MAE 还从 6.4 压到 3.7。它只把”决定要调工具的回合”的思考保留下来,其余照旧剥离——这是设计上的最小成本换取最大收益的默认值。
结论:回放策略是一个”命中率 vs 总字节”的旋钮:命中率好看不代表成本低。never 的 prompt 总量最小、fresh 最高;always 命中率最高但把 prompt 放大 1.55 倍;生产默认的 tool 落在中间,用 13% 的额外字节换 2.1 点的命中率。三个策略的 MAE 都能压到 3.7–6.4 点,说明离线模型对三种布局的预测都成立——离线预测用的是”剥离后”的字节(drop_thinking=True),它对 tool 布局依然贴切,因为纯回答回合的思考本就不该在前缀里。
6.5 单 session 内的累积成本结构
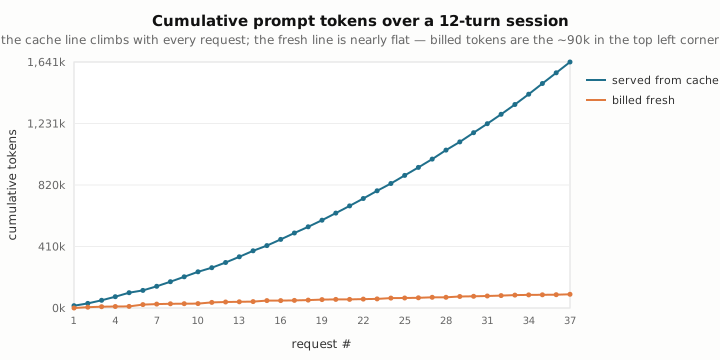
把 §6.2 那个 12 轮 session(22 次重复批次中的主 run,37 个请求)的 prompt token 逐请求累积:“served from cache” 线几乎以 45° 角爬满整张图(最终 1.64M),”billed fresh” 线则基本保持水平(最终 ~92k)。这两条线的形状就是整个评测最想展示的一句话——在 two-zone + append-only 布局下,上下文增长的成本几乎全部被缓存吸收,真正按全价计费的新鲜字节只占 5.3%。
7. 解读指标与图表
7.1 命中率对照图:离线预测 vs 服务器实测
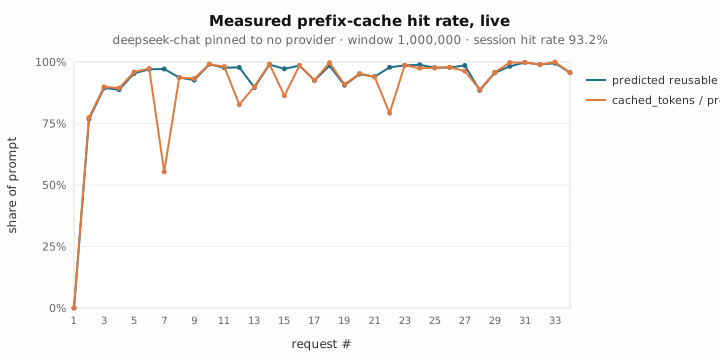
两条线:
- predicted reusable prefix (offline) = 离线预测的每个请求的前缀可复用比
- cached_tokens / prompt_tokens (server) = 服务器实测的命中率
两条线应高度重合。离线预测追踪服务器实测的 MAE 在 5.5 点以内(改前 7.0)。如果服务器线显著低于预测线(且 idle 不长),说明 tokenizer 或编码器有偏差;如果时高时低,说明 provider 不稳定。
7.2 Prompt Token 成分图:缓存命中的数据 vs 新鲜计费
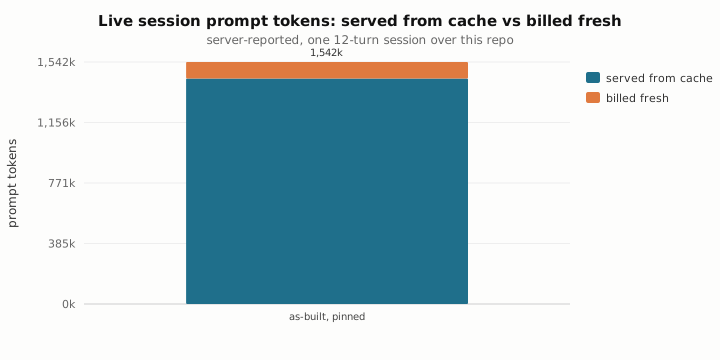
- 绿色 = 已缓存(按缓存价计费,约为原价 20%)
- 灰色 = 新鲜 token(按全价计费)
柱子越矮越好(总 token 少),绿色比例越高越好(缓存省成本)。一个 12 轮 session 总计 ~1.7M prompt token,其中 1.64M 来自缓存,仅有 0.09M 新鲜计费。
7.3 上下文设计对比图:四种变体的可复用前缀
四条线叠加在同一图上。as-built 线最后画(z-order 最高),如果交叉点被 as-built 覆盖住,说明 as-built 是 winner。
7.4 成本对比图
每个 context design 的总额以美元为单位。同一组 session 跑的,柱子之间的差异完全是 context design 的结构差异造成的。as-built 只需 $0.020,no-ledger $0.025(+23%),three-zone $0.053(+162%)。
7.5 多 session 分布
live_acceptance.json 中 --repeat N 后在 main_aggregate 块中:
{"session_hit_rate": {"p10": 0.937, "median": 0.947, "p90": 0.953}}
- P10 和 P90 跨度小(<3 点)→ provider 稳定,设计验证可信
- P10 和 P90 跨度大(>10 点)→ provider 的 KV cache 不稳定,换 endpoint 或缩小上下文
aggregate 的细粒度版本是 live_hit_rate_band.svg(§6.2):逐请求画出 median 线并带 P10/P90 带宽。读法:
- 带宽窄且 median 高(本报告:请求 21 之后带宽 <8 点、median 96–100%)→ 命中率是设计行为,不是运气。
- 带宽宽的请求集中在 session 前 1/3(请求 1–12,最高 45 点)→ 冷启动 + 新 turn 文件内容在不同重复间的错位对齐,是”轮到新内容”的请求,不是 provider 稳定性问题。
7.6 一致性检验(accounting_consistent)
live_acceptance.json 中每个 per-request 有 accounting_consistent 字段。如果为 false,说明服务器报告的 cached_tokens + miss_tokens ≠ prompt_tokens。这通常在报表最后作为 warning 提示。
7.7 时间戳与驱逐证据(idle_s)
live_acceptance.txt 报告的表格里每行有一个 idle 列。当一个低命中率请求出现时,看它的 idle 值:
- idle 长(>60s) → 大概率是 provider 驱逐了缓存
- idle 短(<5s) → 不是驱逐,应该回溯到
wire_text模型或 server 端 bug
7.8 对话长度对比图
三条曲线(P10 / median / P90)在 6 → 12 → 18 turns 上整体上移,12 → 18 趋平。看三点:
- 6 turns 落后:前缀还没攒够就结束了,median 低且 P10 明显掉队。
- 12→18 turns 趋平:P10/median/P90 在 12 轮和 18 轮之间只差不到 0.4 点,缓存效果在 12 轮已饱和。
- 18 turns 的 P10–P90 跨度收窄到 0.6 点:对话越长,冷启动占比越小,provider 抖动被进一步稀释——分布宽度本身就是”缓存稳定性随长度改善”的证据。
7.9 推理回放策略对比图
柱子是三种 --reasoning-strip 策略的命中率中位数。回放越多命中率越高,但柱子的”高度”和它的成本不成正比——高度只反映命中率,成本要结合 reasoning_modes_tokens.svg 里的柱高(总 prompt 量)和 reasoning_tokens_by_mode.svg(每 session 回放的思考 token)一起看。命中率最高(always)的方案把 prompt 总量放大了 1.55 倍,正是 §3.4 说”不值得”的做法。
7.10 累积成本结构图
一条近似 45° 的缓存线和一条近乎水平的 fresh 线。读法:
- 缓存线斜率 = 上下文增长速度,对话越长越陡,但对应的是缓存价(~20%)。
- fresh 线几乎不动 → 新鲜计费字节不随对话增长,成本被前缀稳定性”锁死”在低位。
- 两条线之间的垂直距离就是该设计省下的钱,随轮数单调扩大。
8. 和市面上其他 Coding Agent 的区别在哪?
写到这里必须诚实回答一个问题:这些设计和市面上的主流 Agent 比起来,到底是独立思考还是殊途同归?
8.1 先说实话:核心原则已经行业收敛
Claude Code 团队 2026 年 4 月的博客 Lessons from building Claude Code: Prompt caching is everything 公开的经验,和本文 §3 的设计高度重合:
- 静态内容前置、动态内容后置(对应 §3.1 两区布局);
- 不改 system prompt,而是往 messages 里追加
<system-reminder>(对应”volatile facts belong in the user turn”); - plan mode 做成工具调用而不是模式切换,状态转换不触碰前缀;
- session 内不增删工具,MCP 工具用
defer_loadingstub 占位保持前缀稳定(对应 §3.5 工具集锁定)。
两区布局、append-only、compaction 这些”原则”已经不是差异点,是行业共识。 Claude Code 甚至把命中率当 SLO 监控、命中率过低按事故(SEV)处理——这和本文把 KVCache 当工程指标评测的立场一致。
反面教材也存在:Cline 的系统提示内嵌 cwd、时间、模式等环境细节,随请求变化,曾有用户报告一个 “hello” 就触发近 10k token 的系统提示传输(issue #4047);Cursor 则把缓存标记完全交给服务端透明处理,用户无法控制。这类”每请求动态组装”的设计正是 §3.5 划清界限的对象。
8.2 差异
本质上的差异在于:
- 上下文治理方向:Anthropic 是驱逐导向:Anthropic 的 context editing 按阈值清除旧 tool result / thinking block,compaction 把历史换成摘要,总之方案都是先读内容然后再清理,每次清除在前缀上做修改; whalepod在入口去重:ContextLedger 让重复内容根本不进入窗口(一行指针替代上千 token 的文件内容)。两者互补,这种提前防范的尝试还鲜有人涉及。
- 稳定性保证机制:靠约定:官方文档说明”别中途换模型”、”别动系统提示”等,违反了就缓存失效; whalepod靠稳定构造:工具集在 session 构造时过滤锁定(§3.5)、prompt 一次组装后字节冻结、指南与 schema 同体定义防漂移——违规在结构上不可能发生。
- 验证文化:开源 Agent 几乎没人测量并公布命中率数据。作为实验项目,whalepod的离线字节级预测器 + 在线实测 MAE 对照 + 22 session P10/P90 分布 + 四种设计变体消融实验(§6.1),每一项决策的贡献都有实测结果。未来演进也会按照严格说明效果的方向推进。
第二梯队的细节差异:
- Reasoning 回放策略:DeepSeek 系模型的特有问题(CoT 是否回放)。西方 Agent 主要面向 Anthropic/OpenAI,不面对这个选择;WhalePod 用三策略 × 10 session 的 A/B 实验量化了旋钮代价(§6.4),而不是拍脑袋定默认值。
- Provider pinning:OpenRouter 场景下 0.4% → 98.4% 的实测对比(§3.3),大家知道该做,但很少给出数字。
- BPE 级细节:CRLF 归一化保证 tokenizer 输出稳定(§3.7)——这种粒度的坑只有自己踩过才知道。
- 反例也要认:Claude Code 的
defer_loading+ tool search 处理大规模 MCP 工具集,比 WhalePod 的”启动时锁死”更灵活——工具多到几百个时,静态全量 schema 本身就是负担。这是值得借鉴的方向。
原则层面大家已经趋同。真正的区别在于:主流把前缀稳定性当作编码规范来遵守、把旧内容当作待清理的负担来治理;WhalePod 把它当作类型系统的约束来构造、把重复内容当作不该发生的输入来拦截,并且用一套离线预测 + 在线对照的评测体系证明每一项决策的贡献。 当然强限制可能造成一些使用上的无法处理的问题,未来会在自举迭代中优化。
9. 结论
WhalePod 的 two-zone + append-only + context-ledger 设计在 DeepSeek V4 官方 API 上通过了统计学意义上的验证:
- 12 轮对话命中率中位数 94.7%(22 次独立 session,P10=93.7%,P90=95.3%),P10–P90 跨度仅 1.6 点,性能一致可复现。
- 不同长度对话均稳健:6 轮 91.7%,12 轮 94.7%,18 轮 95.0%——对话越长缓存效果越好,且新鲜计费 token 不随长度增长(始终 ~60–90k),12 轮是性价比甜点。
- 推理回放策略验证了生产默认值:never/tool/always 三种策略的命中率分别为 94.3%/96.4%/97.1%,prompt 总量 1.42M/1.60M/2.20M。回放是命中率与总字节的权衡旋钮,生产默认的 tool(仅工具轮回放)用 13% 的额外字节换 2.1 点命中率,always 则把 prompt 放大 1.55 倍只多换 0.7 点,已无性价比。
- 架构设计经过检验:两区存储 + ledger + reasoning 控制回放 + compaction 七项决策的叠加效果在真实场景中持续兑现 90%+ 缓存命中率,一种是字节级前缀稳定性的系统性保证。